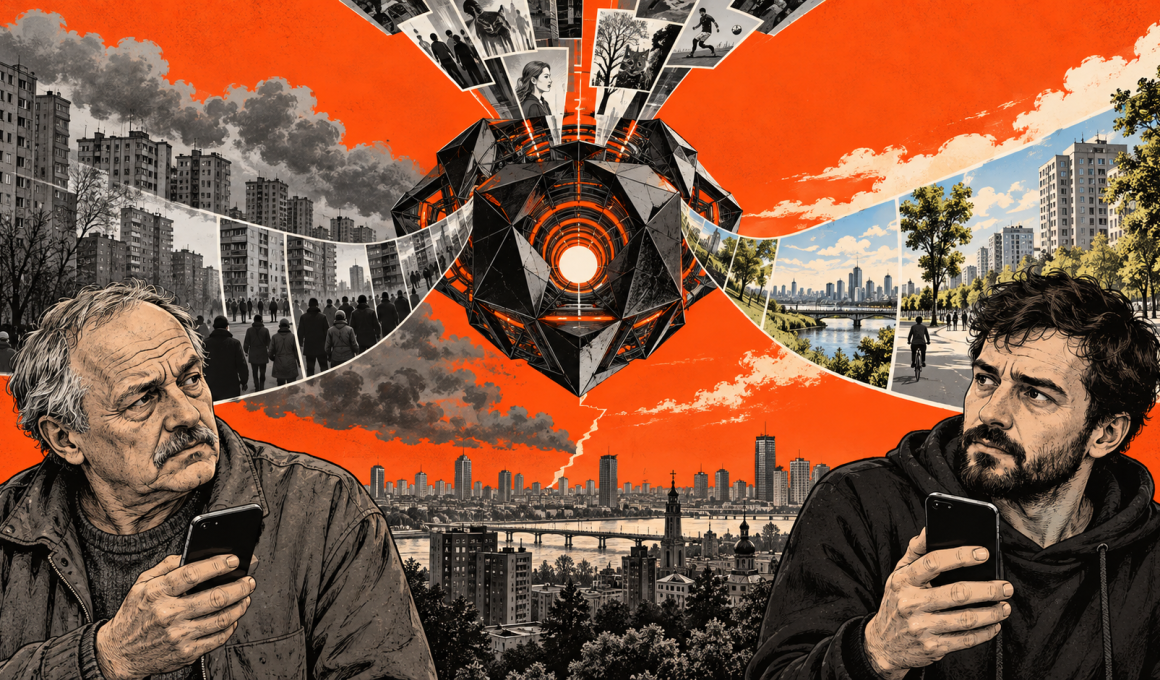
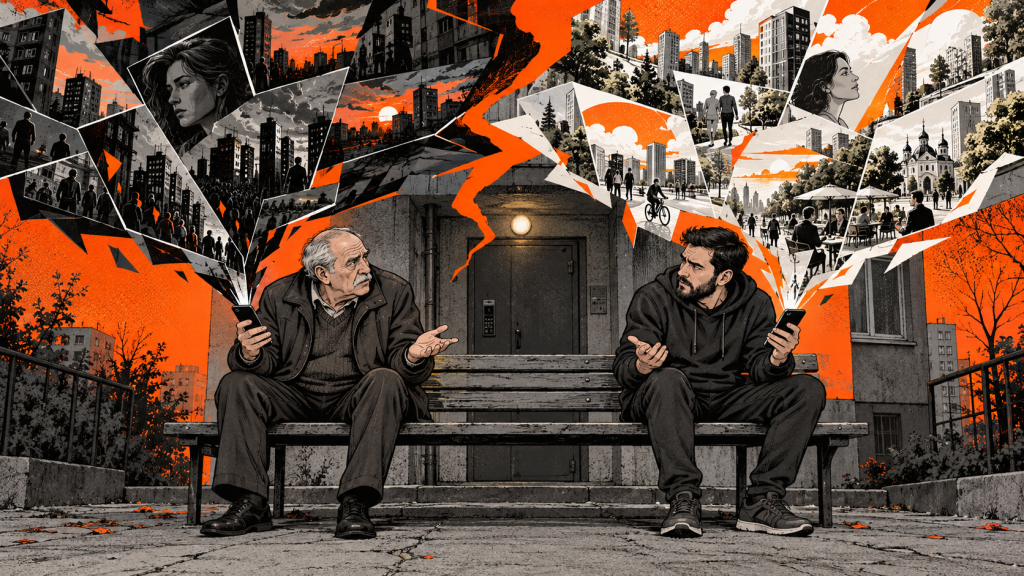
«Нє, ну ти чув, що вони зробили? Вони передали нашу поліцію в управління США», — каже дядя Боря. Я сиджу навпроти нього на лавочці біля під'їзду, в якому ми живемо, затягуюся цигаркою та запитую: «Хто вони?». «Та про це всі ж зараз говорять! Ти що, в інтернет не заходив?», — відповідає дядя Боря. Я заходив. І такої теорії змови, а я за ними уважно слідкую, не бачив.
Ще 20 років тому дядя Боря розказав би мені, що він побачив би в телевізорі на одному із сотні супутникових каналів. Попри те, що я тоді не дивився телебачення, мені було би легше його зрозуміти, бо ми жили в одній інформаційній бульбашці.
Як алгоритм опинився між дядею Борею та інформацією
Перші великі соціальні мережі будувалися насамперед навколо зв'язків між людьми. Користувач сам визначав своє інформаційне оточення: додавав друзів, підписувався на сторінки, медіа, політиків або музикантів. Після цього завдання платформи полягало переважно у вирішенні, які публікації френдів і сторінок показати першими.
У теорії соцмереж таку структуру називають соціальним графом. Люди в ньому є вузлами, а дружба, підписка чи інший зв'язок — ребрами між ними. Соціальна мережа знала, з ким користувач пов'язаний, і використовувала ці зв'язки як головний спосіб поширення інформації.
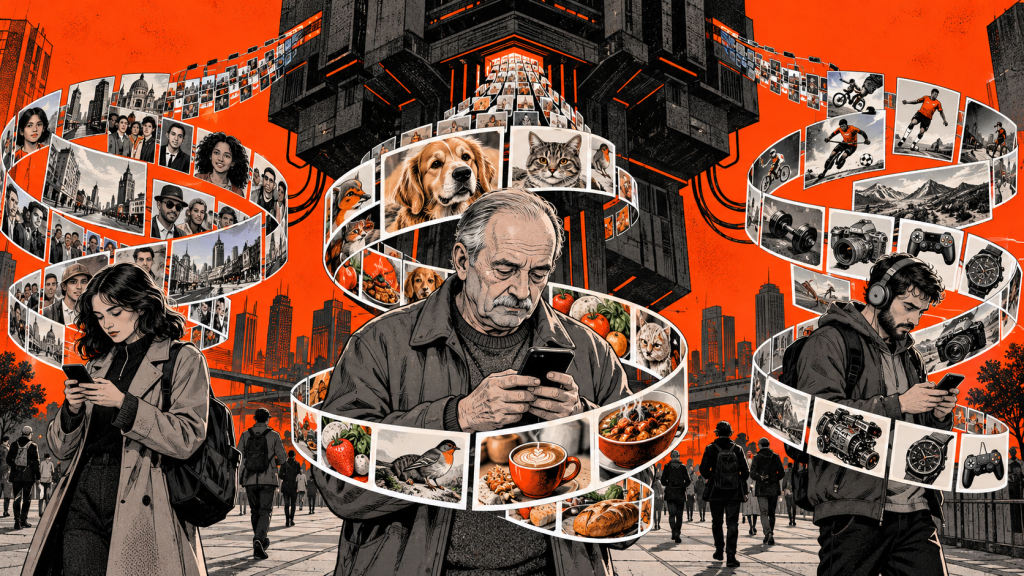
Однак контенту ставало все більше, люди заводили все нових і нових друзів. Якщо людина підписана на сотні акаунтів, між двома її відвідуваннями можуть з'явитися сотні або тисячі потенційних повідомлень. Показати все неможливо.
Одним із переламних моментів стала стрічка новин у фейсбуці в 2006 році. Замість необхідності заходити на сторінку кожного друга користувач отримав централізований потік оновлень. Згодом фейсбук, аби відфільтрувати нерелевантний контент, ввів систему EdgeRank. Вона стала протоалгоритмом соціальних мереж. EdgeRank враховувала, наскільки користувач пов'язаний з автором, тип їх звичної взаємодії та свіжість контенту.
Але згодом і EdgeRank перестав справлятись з інформаційним перевантаженням платформи. У 2013 році фейсбук запровадив Story Bumping: якщо старіша публікація отримала високу оцінку релевантності, але користувач її ще не бачив, система могла повернути її нагору стрічки, поставивши вище за новіший контент.
З'явився і сигнал Last Actor: система тимчасово надавала додаткову вагу матеріалам людей, з якими користувач нещодавно взаємодіяв. Соцмережа все менше оцінювала «наскільки важлива ця публікація взагалі?» та все більше «наскільки ця конкретна публікація буде важливою саме для цієї людини саме зараз?».
До початку 2020-х ця система стала багатоступеневою. Стрічка новин збирала всі публікації, які потенційно могла показати конкретному користувачеві, відсіювала більшість і залишала приблизно 500 найбільш релевантних. На наступному етапі публікації оцінювали ще точніше. Система намагалася передбачити, як людина відреагує на кожну: чи поставить уподобайку, прокоментує, поширить або виконає іншу дію. На основі цих прогнозів кожна публікація отримувала рейтинг.
Наступною й дотепер останньою революцією стала смерть соціального графа. Алгоритми перестали орієнтуватися на те, з ким ви дружите чи на кого підписані. Людині не потрібно спочатку створити велику мережу друзів та підписок, аби платформа формувала для неї персоналізований контент. Найяскравіше ця модель проявилась у тіктоку. Головною стрічкою тіктоку стали не підписки, а For You — нескінченний потік відео, більшість авторів яких користувач взагалі не знає.
Алгоритми виходять у реальний світ
Алгоритми змінили не лише те, побачите ви сьогодні в стрічці смішного лабрадора чи як Настя Каменських розповідає про свою україномовну кісту. Їхні прогнози дедалі частіше стають частиною механізму, за допомогою якого суспільство розподіляє гроші, увагу, роботу, допомогу, контроль і можливості.
Соціологині Дженна Баррелл і Маріон Фуркад в огляді «Суспільство алгоритмів» пишуть, що математична оптимізація та прогнозування проникли в освіту, медицину, фінанси та кримінальну юстицію. Авторки називають це поширенням актуарної логіки: рішення про конкретну людину дедалі частіше приймають на основі статистичної оцінки: що з нею, ймовірно, станеться в майбутньому.
Механізм у різних сферах відрізняється, але загальний принцип схожий. Система отримує велику кількість попередніх випадків, для яких результат уже відомий, шукає закономірності, а потім застосовує їх до нової людини. Але до алгоритмів і етичності їхнього використання в повсякденному житті є купа запитань.
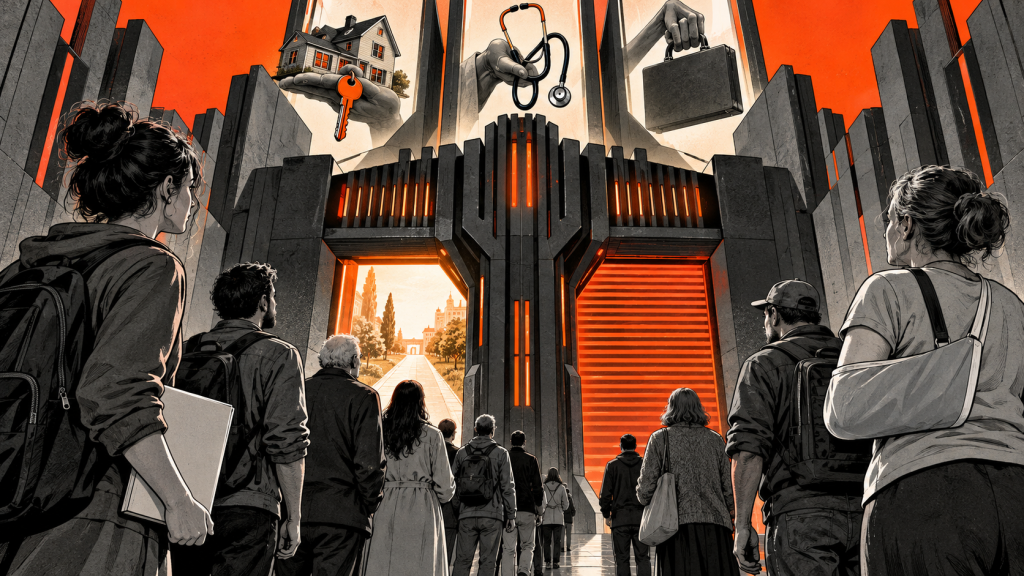
Нові освітні системи аналізують поведінку студентів, які навчаються онлайн: чи часто вони заходять на платформу, чи виконують завдання, як змінюється активність, чи є довгі періоди без взаємодії. На основі цих результатів вони прогнозують, чи має студент високі шанси на відрахування.
Банки за допомогою алгоритмів намагаються передбачити, чи повернете ви кредит, страхові компанії — чи потрапите в халепу. Ба більше: алгоритми вже ухвалюють рішення, чи доставити ваше резюме HR-менеджеру компанії, де ви хочете працювати, чи назавжди залишити його в кошику електронної пошти.
У 2019 році дослідники вивчили комерційний алгоритм, який використовували для визначення пацієнтів, що потребують додаткової медичної допомоги. Система працювала з мільйонами людей, але прогнозувала не стан здоров'я, а майбутні витрати на лікування.
На перший погляд, це логічно: тяжче хвора людина потребує більше медичних послуг і коштує системі дорожче. Але через нерівний доступ до медицини на темношкірих пацієнтів у США історично витрачали менше коштів, ніж на білошкірих із таким самим рівнем захворювань. За однакового бала ризику темношкірі пацієнти потребували більше допомоги за білих. Алгоритм не був расистом і працював коректно. Проблема в тому, що питання «Хто потребує більше допомоги?» непомітно перетворилося на «На кого медицина витратить більше грошей?».
Ще більші питання виникають, коли держава використовує алгоритми для розв'язання соціальних проблем або зі злочинністю. У каліфорнійському окрузі Санта-Клара працювала система Silicon Valley Triage Tool. Алгоритм використовував дані сімох державних установ, аби визначити, які бездомні люди з найбільшою ймовірністю стануть «дорогими» користувачами державних послуг протягом наступного року. Їх мали пріоритезувати для отримання постійного житла. «Потребу в допомозі» фактично замінили на «майбутні витрати для держави» — і через це молоді люди могли отримувати менше уваги, бо турбота про них потребувала менше грошей.
Ще показовіший приклад — захист дітей в окрузі Аллегені. Алгоритм мав допомагати визначати ризик жорстокого поводження з дитиною. Але насильство важко виміряти напряму, тому система використовувала два показники: чи надходили повторні скарги про жорстоке поводження та чи потрапляла дитина в прийомну сім'ю. Модель частково прогнозувала поведінку громади й державної системи, а не саме насильство.
У поліції додається ще проблема: алгоритм може почати створювати дані, які підтверджують його власний прогноз. Системи predictive policing, які прогнозують, куди варто направити поліцейські патрулі, ризикують потрапити в петлю зворотного зв'язку: частіше відправляти поліцію в одні й ті самі райони, знаходити там більше правопорушень і використовувати ці знахідки як підтвердження власного прогнозу.
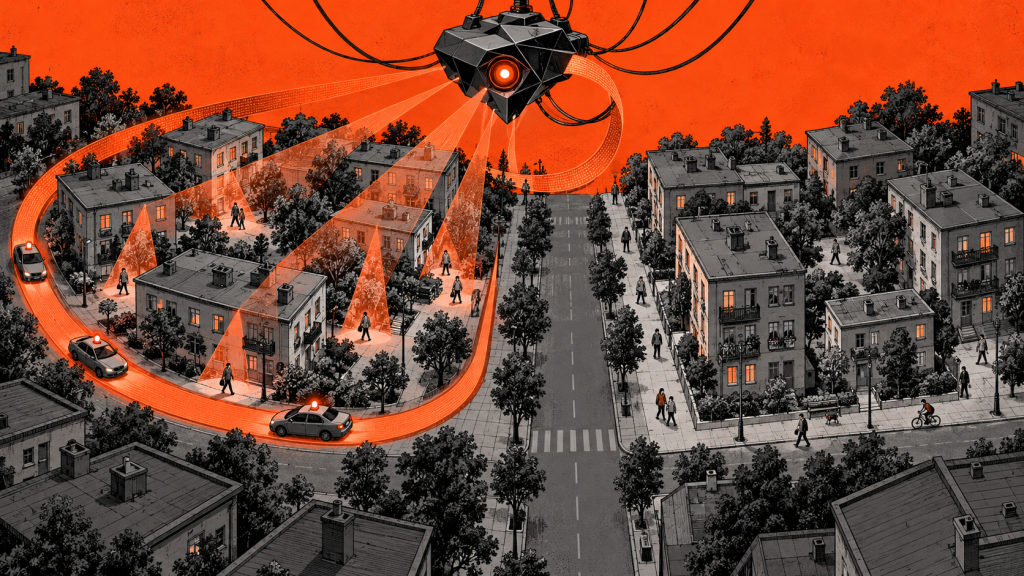
Дослідники змоделювали роботу такого механізму й показали, що він може зациклитися навіть у ситуації, коли два райони мають однаковий реальний рівень злочинності. Через початкову різницю в даних один із районів може отримати більше поліцейської уваги. Поліція знаходить там нові правопорушення, система отримує ще більше даних саме про цей район і наступного разу знову відправляє патруль туди. Водночас район, куди поліція майже не їздить, дає системі мало нової інформації.
Політики, які підлаштовуються під виборця
Алгоритми змінили й людську політику. Ні, попри поширений міф, вони не навчилися безпосередньо вказувати людям, що потрібно голосувати за популістів, усе не так драматично. Їхній вплив починається раніше: з того, який політичний спектр людина взагалі бачить.
У дослідженні «Теорія соціальної ідентичності та алгоритмічне упередження» автори проаналізували понад 300 тисяч політичних відео на ютубі та 1,7 мільйона зв'язків між рекомендаціями. Виявилося, що алгоритми можуть поступово вести користувача від поміркованого контенту до радикальніших позицій усередині його політичного табору.
При цьому, коли в стрічку потрапляла інформація з табору політичних опонентів, користувач отримував не поміркований контент, а одразу екстремальний. У результаті людина могла отримувати викривлену картину політичного поля: власний табір здавався жорсткішим, а опоненти — радикальнішими, ніж вони є в середньому.
Окей, алгоритми змінили інформаційне середовище, але чи здатні змінювати політичні погляди? Великий експеримент фейсбука та інстаграма під час президентських виборів у США 2020 року показав, що заміна алгоритмічної стрічки на хронологічну суттєво міняла контент, який бачили люди. Вона зменшувала їхню активність у соцмережі; утім, дослідники не знайшли помітного впливу на політичні погляди чи поляризацію.
У 2026 році вчені провели ще один незалежний експеримент із користувачами X (колишнього Twitter). Протягом семи тижнів частина учасників користувалася хронологічною стрічкою, а частина — алгоритмічною.
Для людей, які до експерименту користувалися хронологічною стрічкою, перехід на алгоритмічну дав вимірювані політичні зміни. Вони на 4,7 відсоткових пунктів частіше називали пріоритетними теми, характерні для республіканського порядку денного, на 5,5 відсоткових пунктів частіше вважали кримінальні розслідування проти Дональда Трампа неприйнятними. Позитивне ставлення до президента України Володимира Зеленського траплялося на 7,4 відсоткових пунктів рідше.
Водночас дослідники не зафіксували значущої зміни партійної ідентичності чи афективної поляризації. Люди не почали масово називати себе республіканцями чи сильніше ненавидіти прихильників іншої партії.
Професор філософії Томас Крістіано з Університету Аризони у статті «Алгоритми, маніпуляції та демократія» виділяє два механізми, які особливо важливі для політики. Перший — мікротаргетування, коли різним невеликим групам людей показують різні повідомлення залежно від того, що про них відомо.
Другий він називає «гіперпідштовхуванням»: система не просто один раз обирає інформацію, а продовжує стежити за реакціями людини та змінює наступні повідомлення відповідно до її поведінки. Крістіано порівнює це з навігатором, який перебудовує маршрут після кожного неправильного повороту.
Саме тут, на думку Крістіано, виникає нова проблема для демократії. Щоби бути виборцем, не потрібно професійно займатися політикою. Умовний дядя Боря може проголосувати на виборах, не прочитавши жодного законопроєкту, не перевіривши бюджет держави та не вивчивши обіцянки всіх кандидатів. І це нормально: у більшості людей просто немає стільки часу й сил. Тому ми довіряємо знайомим медіа, експертам, партіям, людям зі свого оточення чи власному попередньому досвіду.
Алгоритмічне таргетування робить цю проблему глибшою. Політичний штаб може розділити аудиторію на дуже вузькі групи й показувати кожній різні повідомлення залежно від того, що, за даними системи, найкраще подіє. Для одних це може бути тема податків, для інших — міграції, безпеки чи війни.
Такі повідомлення можна постійно коригувати залежно від реакції аудиторії. В результаті політична кампанія отримує можливість не просто звертатися до всіх однаково, а шукати саме ті аргументи, емоції чи страхи, які найкраще працюють на конкретну групу. Дяді Борі, своєю чергою, не будуть прискіпливо розбиратись і порівнювати «своє» повідомлення з тим, що цей же політик говорить іншим людям.
Наше світле майбутнє (з алгоритмами)
У 2017 році Pew Research Center попросив дослідників і технологічних експертів спрогнозувати, як зміниться роль алгоритмів у наступне десятиріччя. Одна з головних відповідей звучала доволі буденно: алгоритмів стане набагато більше, причому більшість із них люди навіть не помічатимуть. Вони працюватимуть усередині банків, лікарень, транспорту, державних сервісів і компаній, впливаючи на рішення, які раніше приймала людина. Автори звіту Лі Рейні та Джанна Андерсон називали саме цю непомітність однією з головних рис майбутнього поширення алгоритмів.
Та найцікавіше питання полягає вже не в тому, скільки алгоритмічних систем буде навколо нас. Значно важливіше — що станеться, коли дедалі більше рішень почнуть ухвалювати на основі прогнозу, що людина зробить у майбутньому.
Соціолог Каліфорнійського університету в Сан-Дієго Акош Рона-Таш звертає увагу на просте обмеження алгоритмічних прогнозів: алгоритм не знає майбутнього. Він дивиться, що відбувалося раніше, знаходить повторювані закономірності та припускає, що вони працюватимуть і надалі.
Але після цього прогноз починає впливати на саму реальність. Банк може дати такому клієнту кредит під вищий відсоток або на гірших умовах. Через це повертати гроші дійсно стає складніше. Якщо людина зрештою не впорається з платежами, цей випадок потрапить у нові дані й стане ще одним підтвердженням, що клієнти з подібними характеристиками є ризикованими.
Рона-Таш називає це небезпекою самоздійснюваного прогнозу: система не лише передбачатиме поведінку людини, а своїм рішенням може збільшити ймовірність саме такого результату.
Досі більшість алгоритмів, з якими ми стикалися в інтернеті, переважно вирішували, що з уже створеного показати конкретній людині. Фейсбук обирав допис, тікток — наступне відео, гугл — порядок результатів пошуку. Генеративний штучний інтелект змінює цю схему: тепер система може не лише вибрати повідомлення, а й створити його спеціально для конкретного користувача.
Мігель Анхель Ескотет прогнозує появу дедалі більш персоналізованого синтетичного контенту, створеного ШІ та доставленого конкретному користувачу. Йдеться вже не лише про дипфейки, однакові для мільйонів людей. Текст, голос, зображення й відео можна буде створювати в реальному часі з урахуванням того, що система знає про користувача.
Це може ще сильніше розділити інформаційне середовище. Сьогодні двоє людей можуть отримати в тіктоку зовсім різні набори відео, але самі відео принаймні існують незалежно від них, їх можна показати одне одному.
Якщо повідомлення генерується штучним інтелектом під конкретного користувача, інша людина може його взагалі ніколи не побачити. Ескотет вважає, що одним із ризиків такого розвитку стане подальше руйнування спільного інформаційного простору. Тобто є шанс, що за п'ять років, коли я знов зустріну дядю Борю біля під'їзду, я взагалі не зможу його зрозуміти. Ми матимемо не дві різні версії подій, а житимемо в різних інформаційних реальностях.
І що нам із цим робити?
Томас Крістіано пропонує не відмовлятися від рекомендаційних алгоритмів, а змінити те, як вони оптимізують інформацію. Одна з його ідей — вимагати від платформ, щоб алгоритм навмисно залишав у стрічці певне різноманіття поглядів, а не лише підбирав інформацію, яка найкраще відповідає попередній поведінці користувача.
Ідею різноманітнішої стрічки вже перевіряли експериментально. Огляд досліджень рекомендаційних систем у новинних медіа показує: алгоритми можна налаштовувати так, аби вони навмисно додавали до рекомендацій політичні позиції, які не збігаються з поглядами користувача. В одному з таких експериментів це не зробило людей політично активнішими чи краще поінформованими, але підвищило терпимість до протилежних поглядів.
Інший напрям стосується генеративного ШІ. Дослідники пропонують зберігати разом із файлом інформацію про його походження: хто, яка програма його створила, чи редагували його після цього. Так згенерований ШІ контент маркують гугл й Anthropic.
Є рішення, спрямовані не на алгоритм, а на людину. Гордон Пеннікук і Девід Ренд у серії експериментів показали, що навіть нагадування подумати про точність інформації перед поширенням зменшує схильність людей ділитися неправдивими новинами.
Але для нас із дядею Борею, мабуть, найважливіша така ініціатива: повернути людині можливість бачити й змінювати правила, за якими формується її стрічка. Дослідники цифрових платформ і прав людини пропонують надавати користувачам вибір між персоналізованими й неперсоналізованими рекомендаціями, можливість виключати певні джерела й теми та вимагати від платформ пояснювати, чому конкретний матеріал потрапив у рекомендації.
Жоден із цих способів не поверне інтернет у часи, коли всі дивилися одні й ті самі новини. Питання радше в тому, чи залишиться в персоналізованому інтернеті спільний простір, аби люди з різними поглядами хоча б сперечалися про одні й ті самі факти.